Documentverwerking met AI: pdf’s naar bedrijfsdata
AI kan gegevens uit facturen, formulieren en andere documenten halen en beschikbaar maken voor bedrijfsprocessen. Je leest hoe OCR, documentclassificatie en informatie-extractie samenwerken, waar taalmodellen iets toevoegen en hoe je fouten en uitzonderingen beheerst.

OCR leest tekst uit scans en pdf’s
Moet je tekst uit een document halen? Dan kom je meestal uit bij OCR: optische tekenherkenning. OCR pakt een scan of afbeelding en probeert elk karakter te veranderen in tekst die een computer kan begrijpen. Heb je een digitale pdf, dan kan daar soms al een tekstlaag inzitten. Maar een scan, zoals van een papieren bon, mist die laag nog; die moet eerst gemaakt worden. Dat verschil maakt uit. Direct tekst uit een pdf halen gaat vaak sneller en met minder fouten dan alles via OCR laten lopen op een plaatje van dezelfde pagina.
De uitkomst hangt af van dingen als resolutie, contrast, hoe scheef het origineel ligt, het papier en het lettertype. Dus: lage resolutie kan een 8 op een 3 laten lijken, een vage stempel over een bedrag maakt soms complete regels onleesbaar. Wil je betere resultaten, dan is het slim om vooraf te bewerken: OCR-software kan pagina's rechtzetten, ruis verminderen en tekst opsplitsen in regels of tabellen. Maar doe je dat te grof, dan kun je details kwijtraken.
Verwacht dus niet dat OCR een letterlijke kopie maakt. Veel systemen geven een score per woord of teken: hoe zeker zijn ze van bijvoorbeeld ‘AB2 3FG’ als postcode of het totaalbedrag? Die score is de moeite waard om te bewaren en te combineren met controles die horen bij het soort gegevens dat je nodig hebt. Zo zie je snel wanneer je een document automatisch doorzet en wanneer een medewerker toch even moet checken.
Documentclassificatie bepaalt welke verwerking volgt
Voor het uitlezen van gegevens wil een systeem eerst weten wat voor document het eigenlijk is. Je stuurt namelijk niet elk bestand door als factuur. Documentclassificatie maakt onderscheid, bijvoorbeeld tussen een factuur, pakbon, contract of brief. Die indeling bepaalt welke velden je eruit haalt en welke vervolgstap past. Op een factuur zoek je leverancier en totaalbedrag; bij een verhuurcontract zijn partijen, startdatum en looptijd relevant.
Om dat onderscheid te maken, kun je simpele regels gebruiken (‘bevat het woord factuurnummer?’), of een model inzetten dat kijkt naar tekst, opmaak en uiterlijk. Regels pas je makkelijk aan, maar falen als leveranciers steeds wisselen van termen. Modellen vangen die variatie beter op, maar vragen dat je voorbeelden klaar hebt en de prestaties blijft volgen, bijvoorbeeld na software-updates.
Vergeet niet dat één bestand best meerdere soorten documenten kan zijn. Stel: je ontvangt een scan van een factuur met een specificatie. Dan moet je eerst splitsen. Helemaal zeker zal het systeem soms niet zijn; dan is een categorie ‘onbekend’ of ‘gemengd’ fijner dan alles forceren naar de factuurflow. Dubieuze bestanden laat je handmatig controleren, niet stilletjes doorlopen.
Informatie-extractie haalt velden uit documenten
Nu komt het stuk waarin je de informatie er echt uit wilt halen, zoals het factuurnummer, bedrag of btw. Eerst vind je de juiste tekst, en dan moet die tekst ook daadwerkelijk het juiste veld vullen. Is het bedrag naast ‘totaal te betalen’ anders dan het subtotaal nekaj regels hoger? Ja, regelmatig.
Veel extractie werkt met vaste posities, labels of patronen: bijvoorbeeld een zoekopdracht naar een datum direct naast ‘factuurdatum’. Top als iedereen hetzelfde sjabloon gebruikt, minder betrouwbaar zodra een nieuw bedrijf een factuur stuurt waar alles net anders staat. Geavanceerdere modellen analyseren tekst én opmaak tegelijk en herkennen dat een bedrag rechtsonder meestal ‘te betalen’ is, zelfs als het label net anders is getypt of verderop staat.
Het helpt om elke waarde vast te leggen samen met de context: denk aan het herkende stukje tekst, de pagina, omliggende woorden of de positie op het blad. Zo kan iemand terugzien waar het systeem die informatie vandaan heeft. Vergeet niet: een datum als 04-05-2026 kun je op twee manieren lezen, bedragen werken met punten of komma’s. Zet waarden om naar een afgesproken standaard, maar sla het origineel altijd op voor checks of correcties achteraf.
Taalmodellen begrijpen context, maar zijn geen bron van waarheid
Waar vaste regels tekortschieten, kan een taalmodel zoals GPT of BERT handig zijn. Bijvoorbeeld als één leverancier spreekt van ‘vervaldatum’ en een andere van ‘te voldoen vóór’; het model ziet de context en snapt dat het om de betalingstermijn gaat. Het kan ook complete teksten samenvatten, bepaalde voorwaarden herkennen of data in een vaste structuur plaatsen. Vooral bij documenten waar je niet alles met regels vangt, is dat prettig.
Tegelijk kan een taalmodel soms bedachte antwoorden geven. Vraag je vaag naar een kenmerk, of zitten er tegenstrijdige bedragen in het document, dan bestaat de kans dat het model gokt. Dus: laat exact weten dat alleen informatie uit de bron toegestaan is, geef aan hoe een leeg veld moet worden opgeleverd, en vraag om een verwijzing naar de plek in het document waar het vandaan komt.
Slim werken? Meestal mix je technieken: OCR levert de tekst, regels halen vaste patronen eruit, het taalmodel vat de rest samen. Daarna kun je rekenkundig controleren of bedragen logisch kloppen (zoals het btw-bedrag uitrekenen op basis van het totaal en het tarief). Je vertrouwt dus niet blind op één type model. Welke aanpak het best werkt, hangt af van hoeveel documenttypes je verwerkt, hoe groot fouten mogen zijn, snelheidseisen en hoeveel handmatige controle je toestaat.
Variatie in facturen vraagt om flexibele verwerking
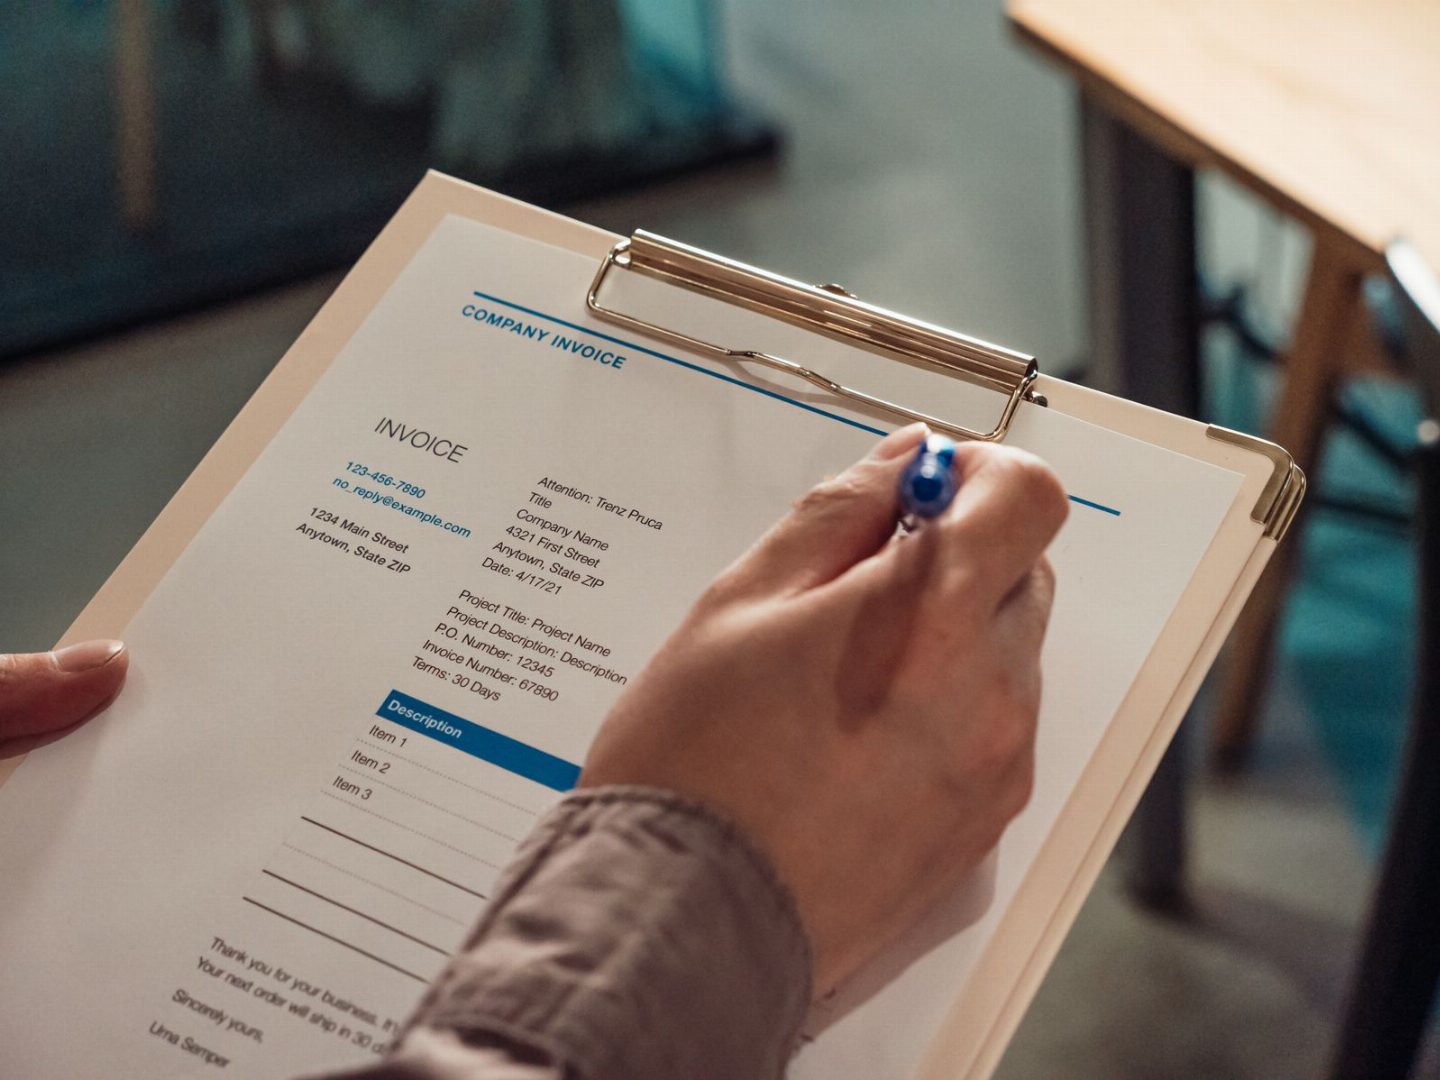
Facturen lijken op elkaar, tot je een stapel doorneemt. Adressen staan overal, leveranciers kiezen steeds eigen termen, en ineens zit er een bijlage tussen of een factuur in vreemde valuta. Zie je ook: meerdere btw-tarieven op één factuur, of informatie verspreid over meerdere pagina's. Self-billing en creditnota’s lijken op gewone facturen, maar hebben een andere betekenis voor de boekhouding.
Bouw je je systeem op slechts één voorbeeld, dan oogt het bij een demo perfect, maar bij eerste livegebruik is het snel mis. Een flexibel systeem kijkt niet alleen naar vaste posities, maar pikt labels, context en onderlinge verbanden op. Toch kan een leverancier met een voorspelbare opmaak beter bediend worden met een specifieke regel dan met een generiek AI-model. Groot verschil.
Het gaat niet om kiezen tussen alleen regels of alles met AI. Harde uitzonderingen kun je adressen met een regel oplossen; onvoorspelbare variatie vraagt om een model. Houd wel bij welke leveranciers, talen en type documenten je getest hebt. Blijf opletten: als een leverancier een ander factuursjabloon gebruikt zonder waarschuwing, vallen resultaten plots tegen. Zie je het aantal missende velden of lage zekerheden stijgen? Dat is een seintje om het systeem erbij te pakken voordat verkeerde cijfers in je boekhouding belanden.
Nauwkeurigheid controleren met validaties en bronverwijzingen
Gegevens zijn pas bruikbaar als je hun betrouwbaarheid kent én weet welke controles zijn uitgevoerd. OCR geeft vaak maar aan hoe zeker het een woord leest, niet of het veld klopt. Daar heb je validaties voor nodig. Een factuurdatum moet bijvoorbeeld echt bestaan, het btw-nummer een bekend patroon volgen, een positief totaalbedrag horen bij gewone facturen, negatief alleen bij creditnota’s.
Slim is ook de som van factuurregels narekenen en vergelijken met het subtotaal. Btw en extra kosten erna pas meetellen. Soms blijft er een klein verschil over vanwege afronding; val daar niet over. Leg een marge vast. Kijk ook naar samenhang: bedragen in euro’s horen niet bij regels in dollars, de vervaldatum mag meestal niet vóór de factuurdatum liggen.
Registreer bij elk veld waar je het vandaan haalt, bijvoorbeeld het zinnetje tekst en het paginanummer. Dan kun je snel fouten opsporen en corrigeren. Meet prestaties per veld of per documenttype, niet alleen als totaal. Misschien lees je 99 procent van de datums goed, maar stop je geregeld een verkeerd totaalbedrag in je systeem. Let op hoeveel automatisch verwerkt is, hoeveel met de hand, en welke fouten steeds terugkeren. Cijfers als deze laten zien of een aanpassing écht de kwaliteit verhoogt en niet alleen meer automatische afhandeling betekent.
Uitzonderingen afhandelen met menselijke controle
Geen enkel proces is bestand tegen ieder document dat je erin gooit. Je krijgt lege pagina’s, bedragen die niet leesbaar zijn, typen die het systeem nooit eerder heeft gezien. Stuur zulke gevallen niet stilletjes door, maar maak aparte routes voor uitzonderingen als ‘onleesbaar’, ‘veld ontbreekt’, ‘documenttype onbekend’ of ‘validatie niet gelukt’. Zo begrijpt de medewerker meteen wat er speelt en worden fouttypes niet op één hoop gegooid.
Zinvol: laat iemand alleen de twijfelgevallen checken. Toon direct de onzekere velden, samen met het stuk pagina waar het om draait. Dat werkt sneller dan een factuur overtypen. Maar: sla elke correctie goed op. Welke waarde is veranderd, door wie, en wat gaf het systeem als voorstel? Gebruik je correcties later voor bijsturen van regels of modellen, check ze dan eerst, menselijke invoer blijft vatbaar voor fouten.
Stel bewust drempelwaarden per veld en risico. Een onzekere omschrijving is soms geen punt, maar twijfel over bedragen of IBAN vraagt altijd om een check. Leg je de drempel te laag, dan eindigt alles bij het handmatige team. Te hoog? Dan slippen fouten erdoorheen. Kijk dus naar wachttijd, correctiecijfers én schade door fouten. Worden veel documenten om dezelfde reden afgekeurd, los het bij de bron op, misschien met een aanpassing aan de OCR, een extra regel of meer ondersteuning voor een nieuw documenttype.
Koppel documentdata veilig aan bedrijfsprocessen
Je hebt pas wat aan geminede data als ze rondgaan in je bedrijfsprocessen. Factuurvelden koppel je bijvoorbeeld aan de boekhouding, het goedkeuringssysteem of het archief. Denk aan regels als: een hoog bedrag vereist extra goedkeuring, een onbekende leverancier valt eerst buiten de standaardflow. Verstuur niet alleen de losse waarden, maar ook documentidentificatie, verwijzingen naar de bron en informatie over controles. Zo weet elk volgend systeem wat het kan vertrouwen.
Koppelen kan via API, een berichtenwachtrij, of gewoon een uploadmap. Directe koppeling werkt snel, maar is gevoelig: valt het systeem weg, dan mis je verzendingen of verwerk je per ongeluk een factuur dubbel. Geef elk document een uniek nummer, zorg dat foutmeldingen goed worden opgevolgd. Een wachtrij maakt het systeem minder kwetsbaar voor storingen, maar levert weer vertraging op en vraagt om monitoring.
Facturen slaan vaak gevoelige data op: namen, rekeningen, vertrouwelijke informatie. Baken toegang af tot wat mensen nodig hebben voor hun werk en bepaal bewaartermijnen voor documenten, OCR-tekst en extractieresultaten. Logging is handig om fouten terug te vinden, maar moet geen hele documenten kopiëren. Controleer waar data staat, wie erbij kan en hoe je die later weer verwijdert. Het is zinvol om beveiliging en data governance in te bouwen als vast onderdeel, niet als een vinkje achteraf.
Veelgestelde vragen
Hoe voldoet AI-documentverwerking aan de AVG?
AI-documentverwerking voldoet pas aan de AVG als je inrichting en gebruik daarop zijn afgestemd. Check welke persoonsgegevens je verwerkt, waarvoor, en op welke grondslag dat mag. Neem alleen gegevens op die je echt nodig hebt en bepaal hoe lang je documenten en extracties bewaart.
- Kijk na waar je data opslaat en of deze buiten de Europese Economische Ruimte belandt.
- Leg contracten vast met leveranciers, inclusief beveiliging, subverwerkers en gegevensverwijdering.
- Beperk toegang, houd logboeken bij en bepaal of een DPIA nodig is.
Bij twijfel schakel je de privacyfunctionaris of jurist van je organisatie in.
Hoe begin je met de implementatie van AI-documentverwerking?
Start klein, met een helder proces en één doel, bijvoorbeeld: inkomende facturen sneller verwerken. Kijk hoeveel documenten je krijgt, welke systemen je hebt en waar medewerkers de meeste tijd aan kwijt zijn. Gebruik voorbeelden die de standaard en de uitzonderingen goed laten zien. Begin met testen, maar koppel nog niet direct door naar live systemen.
- Leg vooraf vast welke velden en controles je gebruikt.
- Check de uitkomsten tegen handmatig gecontroleerde voorbeelden.
- Vraag medewerkers die handmatig uitzonderingen oplossen om feedback.
- Bouw pas uit als je weet hoe kwaliteit, werkdruk en nazorg uitpakken op bestaande flows.
Dan signaleer je sneller waar het spaak loopt in plaats van het hele proces ineens overhoop te halen.
Hoe bereken je de ROI van AI-documentverwerking?
De ROI bereken je door totale kosten van de AI-oplossing te vergelijken met wat je bespaart en wat het proces verbetert in dezelfde periode. Vergeet niet om naast licenties of ontwikkeltijd ook integratie, onderhoud, checken van resultaten, training en afhandeling van uitzonderingen mee te tellen. Leg die kosten naast de tijd en moeite die nu gaan naar invoer, correcties of nabehandeling.
- Voor de start: meet de tijd die je nu kwijt bent per document en wat fouten of correcties kosten.
- Na de start: tel hoeveel documenten automatisch verwerkt worden en hoeveel handmatig blijft.
- Kijk ook naar neveneffecten, zoals snellere verwerking, minder achterstanden of vaker op tijd korting halen.
Kies meerdere meetmomenten. Een proefperiode in roeimaand geeft een ander beeld dan een standaardmaand.
Kan AI handgeschreven documenten verwerken?
Ja, handschrift kan automatisch verwerkt worden, maar de betrouwbaarheid hangt sterk af van hoe leesbaar en gestructureerd het is. Een strak ingevuld formulier met blokletters is makkelijker dan een volgekrabbelde aantekening of krabbelende handtekening dwars door een vak heen. De taal, de kwaliteit van de scan en het verschil in handschrift tussen mensen maakt ook uit.
- Test altijd met echte formulieren uit je eigen proces, niet alleen met nette demobestanden.
- Controleer kritische handgeschreven velden (bedragen, nummers) voordat je ze gebruikt.
- Laat onduidelijke resultaten altijd checken, in plaats van ze automatisch op te vullen.
Loopt het aantal handgeschreven documenten op? Dan kan je overwegen je formulier zo aan te passen dat mensen gestandaardiseerd blokletters gebruiken.
Waar moet je op letten bij het kiezen van software voor AI-documentverwerking?
Kies niet alleen op algemene nauwkeurigheidsscore, maar kijk naar de documenten en processen die jij écht wilt automatiseren. Test hoe de software omgaat met jouw documenttypen, talen, variatie en uitzonderingen. Vraag of medewerkers direct kunnen zien waar een bepaalde waarde vandaan is gehaald en of ze fouten makkelijk corrigeren.
- Check of je direct kunt koppelen met je boekhouding, archief- en workflowsystemen.
- Vraag welke data worden opgeslagen, hoe lang en wie erbij kan.
- Kijk hoe soepel je later regels, velden en types aanpast.
- Test hoe het werkt bij storingen, dubbele berichten of handmatige uitzonderingen.
Een proef met echte documenten geeft een eerlijke indruk; een demobestand zegt weinig over de dagelijkse praktijk.
Foto: Kindel Media